Почему систему нужно проверять после настройки
После монтажа контроллера и датчиков обычно проверяют их текущее состояние. Температура отображается, дверь закрыта, протечки нет, электропитание присутствует — значит, на первый взгляд система работает.
Но такая проверка подтверждает только получение текущих данных. Она не показывает, что произойдёт при реальной аварии.
Например, контроллер может корректно получать температуру от датчика, но уведомление о превышении порога не дойдёт до получателя. Изменение дискретного входа может отображаться в веб-интерфейсе, но соответствующий SNMP Trap не будет обработан внешней системой мониторинга. Настроенное правило автоматизации может сработать по условию, но исполнительное устройство не перейдёт в требуемое состояние.
Поэтому после настройки необходимо не только проверить датчики, но и воспроизвести основные аварийные ситуации.
Что именно нужно проверять
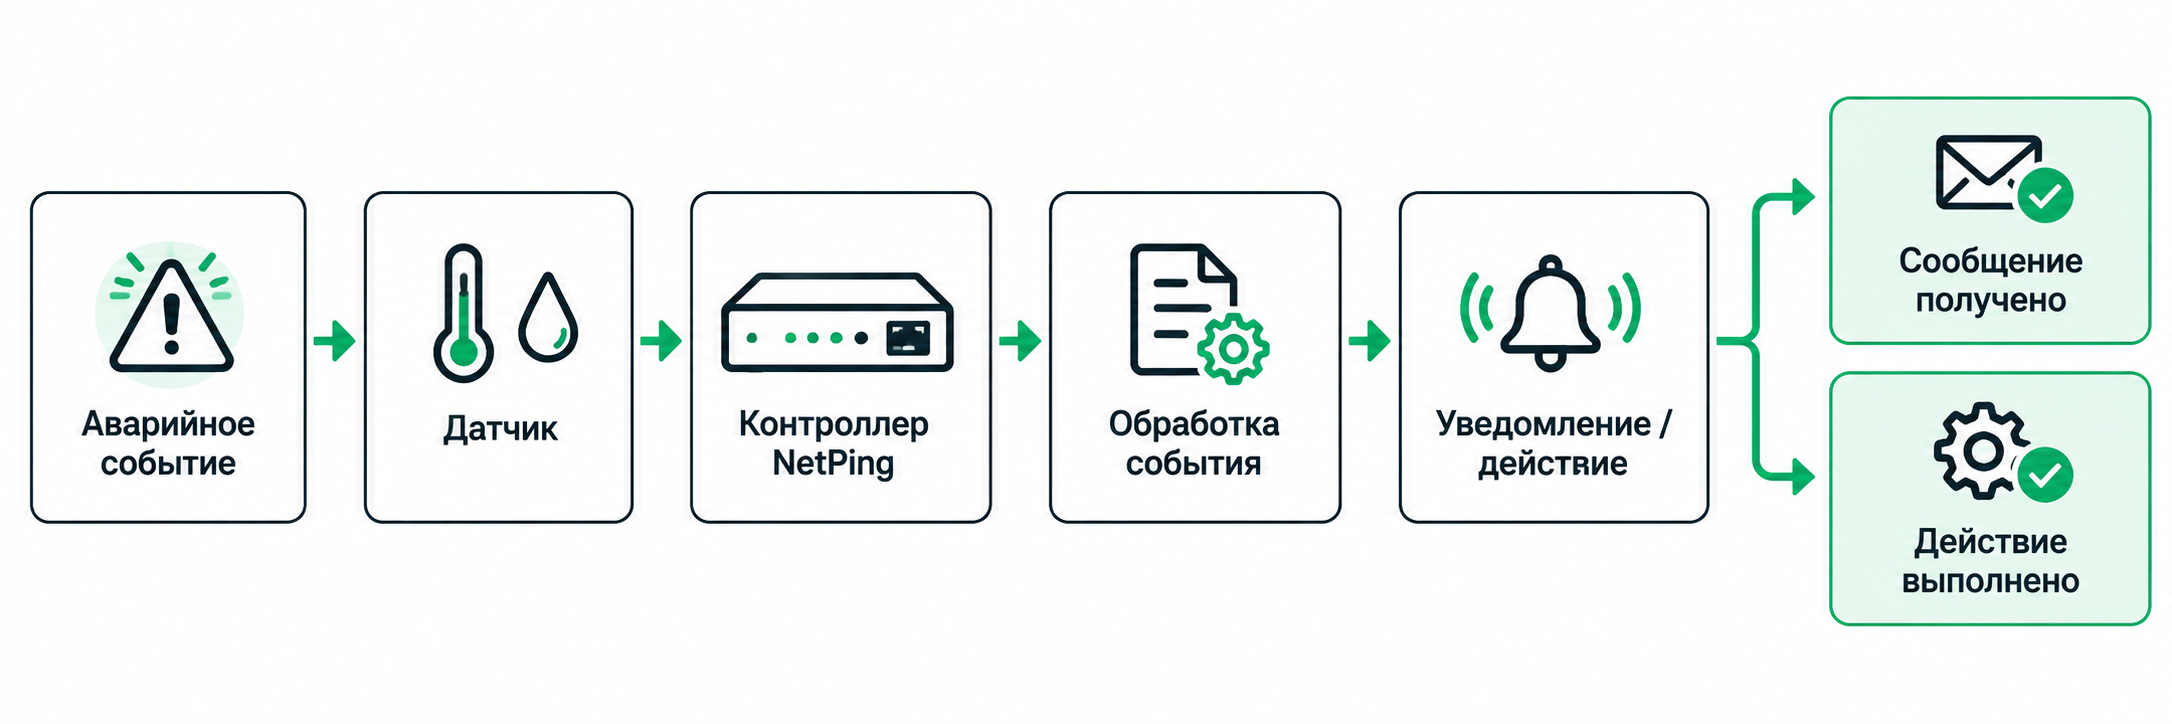
Каждый сценарий начинается с контролируемого события и заканчивается ожидаемым результатом. В простейшем случае последовательность выглядит так:
аварийное событие → датчик → контроллер NetPing → обработка события → уведомление или действие
До начала испытания нужно определить, какое состояние считается аварийным и какой результат ожидается. Например: температура превышает заданную границу → контроллер фиксирует состояние «выше нормы» → формируется уведомление → сообщение поступает ответственному сотруднику.
Если сценарий предусматривает автоматическое управление, к этой последовательности добавляется действие исполнительного устройства: переключение реле, включение вентиляции, сирены или другой подключённой нагрузки.
Контроллеры NetPing в зависимости от модели и конфигурации позволяют получать данные от подключённых датчиков, контролировать состояния дискретных входов, передавать уведомления и выполнять автоматические действия.
Поэтому при подготовке испытаний необходимо исходить из возможностей конкретного устройства и фактически настроенного сценария: какие параметры контролируются, какие события формируются и какая реакция предусмотрена при аварии.
Проверка превышения температуры
Для температурного мониторинга недостаточно убедиться, что контроллер отображает текущее значение датчика. Необходимо проверить переход через установленную границу и реакцию системы на это изменение.
При этом не нужно действительно перегревать серверную, шкаф или оборудование. Для безопасного испытания можно временно установить тестовую границу рядом с текущей температурой либо контролируемо изменить температуру непосредственно в зоне датчика.
Например, если датчик показывает 23 °C, верхнюю тестовую границу можно временно установить на уровне 24 °C. После перехода через неё необходимо убедиться, что контроллер изменил статус датчика и сформировал предусмотренное уведомление.
Отдельно проверяется возврат температуры в нормальный диапазон. Если используется гистерезис, состояние вернётся в норму не обязательно сразу после обратного пересечения установленной границы: необходимо учитывать заданную зону переключения.
Гистерезис предотвращает частую смену состояния при небольших колебаниях температуры около установленной границы. Поэтому при проверке необходимо учитывать не только аварийный порог, но и условия возврата состояния в норму.
После испытания тестовые пороги необходимо вернуть к рабочим значениям.
Проверка дискретных датчиков
Датчики открытия двери, протечки, наличия электропитания и другие устройства с дискретным выходом проверяются физическим изменением их состояния.
В зависимости от установленного оборудования можно:
-
открыть и закрыть контролируемую дверь;
-
безопасно активировать датчик протечки;
-
изменить состояние другого подключённого дискретного датчика;
-
снять напряжение с линии, контролируемой датчиком наличия электропитания.
После физического срабатывания необходимо убедиться, что состояние дискретного входа контроллера изменилось.
При такой проверке важно проконтролировать, правильно ли физическое состояние датчика интерпретируется системой. Для устройств с релейным выходом необходимо учитывать выбранную схему подключения и состояние Н.О./Н.З. контактов. Например, открытая дверь должна интерпретироваться именно как «Открыто», а отсутствие контролируемого электропитания — как «Питания нет».
Для дискретных входов может использоваться текстовая расшифровка логических состояний. Поэтому проверять необходимо не только изменение логического уровня, но и правильность его смысловой интерпретации в уведомлениях и системе мониторинга.
Проверка пропадания электропитания
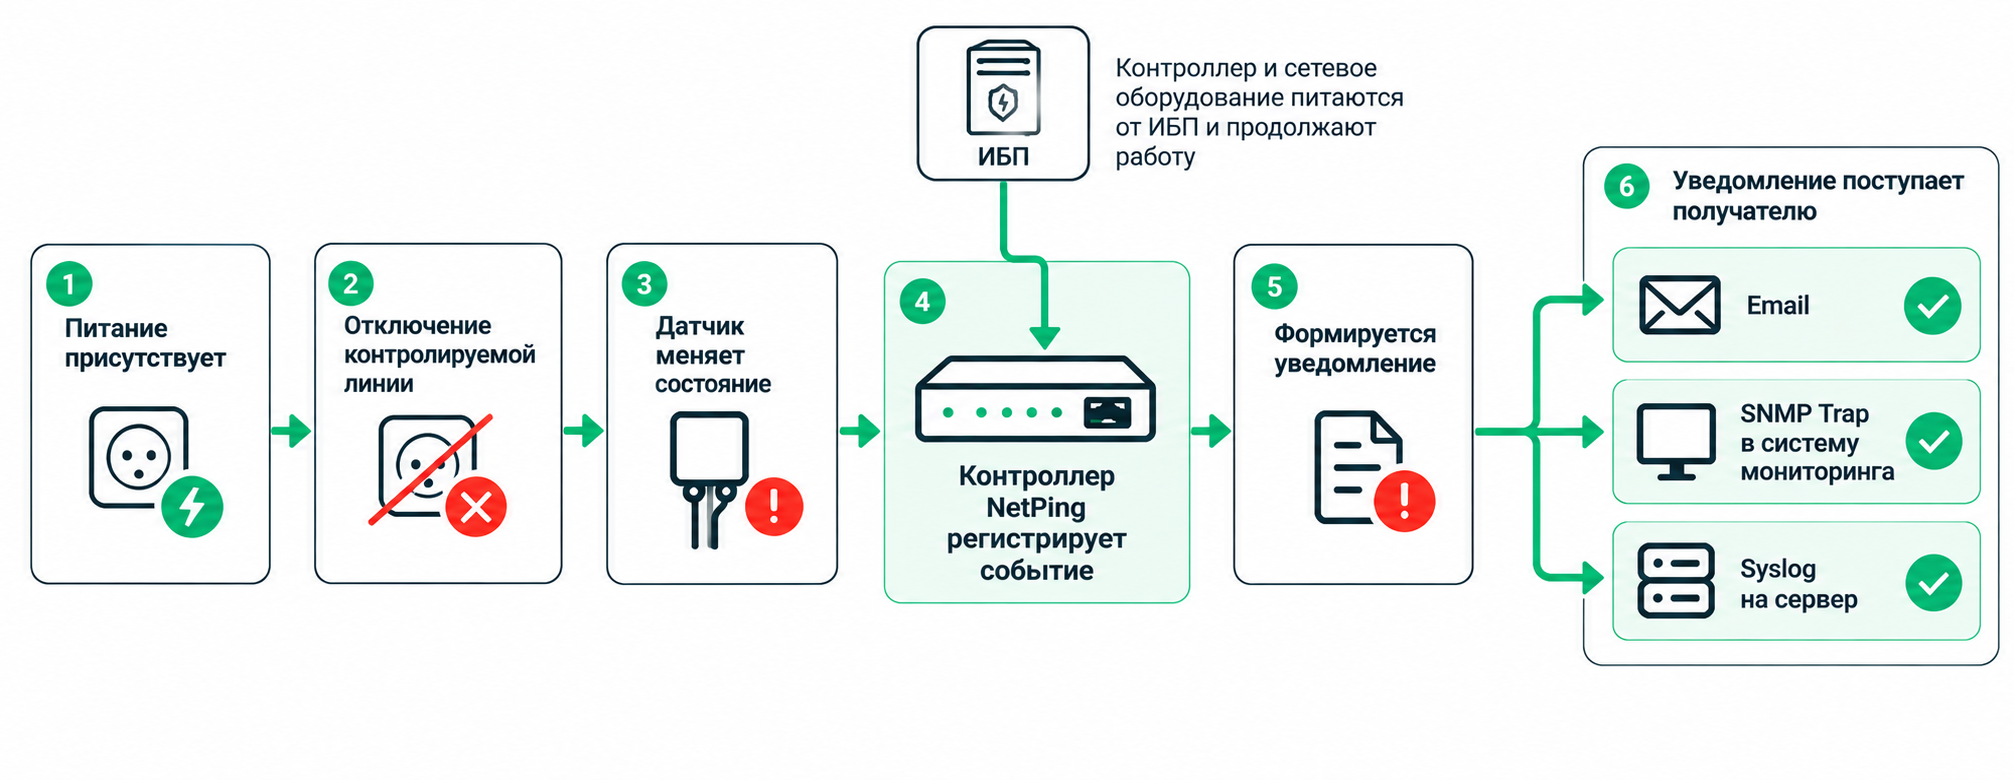
Этот сценарий требует отдельной подготовки. Если контроллер и сетевое оборудование получают питание от той же линии, которую планируется отключить, после её обесточивания сообщение об аварии может быть просто некому и не через что отправлять.
Поэтому до испытания необходимо определить, какие элементы системы должны продолжить работу после отключения контролируемой линии.
Если требуется получить уведомление о пропадании основного питания, контроллер и необходимое для передачи сообщения сетевое оборудование следует запитать так, чтобы они сохраняли работоспособность — например, от ИБП или другой резервируемой линии.
Сам тест может выглядеть следующим образом:
питание присутствует → контролируемая линия отключается → датчик меняет состояние → контроллер регистрирует событие → уведомление поступает получателю.
После этого питание восстанавливается и проверяется возврат датчика в штатное состояние.
Такой тест одновременно проверяет датчик электропитания и способность системы сообщить об аварии в условиях, когда часть инфраструктуры уже обесточена.
Проверка доставки уведомлений
Срабатывание датчика ещё не означает, что информация об аварии дошла до того, кто должен на неё реагировать.
Если настроен Email, необходимо получить письмо на заданный адрес. Если используется SNMP Trap — проверить поступление сообщения в систему мониторинга. Для Syslog — убедиться, что соответствующая запись появилась на сервере сбора сообщений.
Проблема может находиться уже за пределами контроллера: неправильные параметры SMTP-сервера, сетевые ограничения, настройки SNMP или Syslog, недоступность сервера-получателя.
Если события поступают в Zabbix, PRTG или другую систему мониторинга, следует проверить и следующий этап: правильно ли определяется источник события, создаётся ли нужная тревога и достаточно ли информации получает оператор для понимания причины.
Результатом теста должно быть фактическое получение и корректная обработка сообщения в конечной точке, а не только его формирование контроллером.
Проверка автоматических действий
Некоторые контроллеры NetPing позволяют использовать состояния подключённых датчиков и входов в качестве условий для автоматического управления исполнительными выходами. Наличие и возможности такой автоматизации зависят от конкретной модели и версии встроенного ПО.
Например, сценарий может выглядеть так:
превышение температуры → выполнение заданного условия → переключение реле → включение дополнительной вентиляции.
При испытании необходимо убедиться, что условие действительно перешло в требуемое состояние, контроллер выполнил предусмотренное правило, а исполнительное устройство фактически сработало.
Особенно осторожно следует проверять сценарии, связанные с электропитанием серверов, сетевого оборудования, систем охлаждения и другой критичной нагрузки.
Для первоначальной проверки безопаснее использовать тестовую нагрузку. Если это невозможно, испытание следует проводить в согласованное технологическое окно.
Автоматическое правило считается проверенным только после фактического выполнения предусмотренного действия, а не по наличию правила в конфигурации.
Проверка отказа датчика
Аварийной ситуацией может быть не только выход контролируемого параметра за установленные пределы. Сам датчик может быть отключён, повреждён или перестать передавать данные.
Это состояние принципиально отличается от выхода параметра за допустимый диапазон. При превышении температурного порога система располагает измерением и знает, что температура аварийная. При отказе температурного датчика достоверного значения уже нет.
Поэтому для критичных параметров полезно проверить, как система ведёт себя при физическом отключении датчика и предусмотрена ли реакция на потерю данных.
В зависимости от возможностей используемого контроллера отказ датчика может формировать отдельное событие, уведомление или использоваться как условие автоматического сценария.
Отказ средства контроля сам по себе должен рассматриваться как событие, требующее внимания.
Проверка восстановления после аварии
После срабатывания сценария испытание ещё не закончено. Необходимо вернуть контролируемый параметр в нормальное состояние и проверить дальнейшую реакцию системы.
Например, после закрытия двери дискретный вход должен снова отображать штатное состояние. После восстановления электропитания датчик должен зафиксировать его наличие. После снижения температуры статус должен вернуться в норму с учётом настроенных порогов и гистерезиса.
Если сценарий включает автоматическое управление, необходимо убедиться, что исполнительное устройство также перешло в предусмотренное состояние.
После завершения теста следует дополнительно проверить, что временно изменённые пороги, правила и настройки возвращены к рабочим значениям.
Аварийный сценарий должен иметь проверяемое начало и проверяемое завершение.
Проверка нескольких связанных событий
После отдельных тестов имеет смысл проверить хотя бы один составной сценарий. Реальная авария может вызвать сразу несколько событий.
Например, при пропадании электропитания последовательность может выглядеть так:
пропадание питания → срабатывание датчика → уведомление → отключение части оборудования → потеря его сетевой доступности.
Такой тест позволяет увидеть ситуацию с точки зрения оператора: какое событие появляется первым, какие сообщения следуют за ним и можно ли по ним определить первопричину.
Это особенно важно на распределённых объектах, где специалист не видит оборудование физически и принимает решение о дальнейших действиях только по данным мониторинга.
При этом нет необходимости одновременно моделировать большое количество аварий. Достаточно проверить несколько наиболее вероятных последовательностей событий, способных повлиять на диагностику.
Результаты тестирования нужно фиксировать
Чтобы испытания можно было повторить после изменения системы, для основных аварийных сценариев полезно заранее определить ожидаемый результат.
|
Сценарий |
Что имитируем |
Что проверяем |
|---|---|---|
|
Высокая температура |
Пересечение тестовой границы |
Изменение статуса и уведомление |
|
Открытие двери |
Открытие и закрытие двери |
Состояние дискретного входа и уведомление |
|
Протечка |
Безопасное срабатывание датчика |
Аварийное состояние и уведомление |
|
Пропадание питания |
Отключение контролируемой линии |
Срабатывание датчика и доставка уведомления |
|
Отказ датчика |
Отключение датчика |
Обнаружение потери данных |
|
Автоматическое действие |
Выполнение заданного условия |
Фактическое переключение исполнительного выхода |
|
Восстановление |
Устранение тестовой аварии |
Возврат системы в штатное состояние |
Если сценарий завершился не так, как предусмотрено, после устранения причины его необходимо выполнить повторно.
Когда повторять тестирование
Проверка при первоначальном вводе системы в эксплуатацию не гарантирует, что через некоторое время все аварийные сценарии продолжат работать без изменений.
Со временем могут заменяться датчики и контроллеры, изменяться сетевые настройки, адреса серверов мониторинга и SMTP-серверов, получатели уведомлений, пороговые значения и правила автоматизации.
Поэтому основные сценарии стоит повторно проверять:
-
после первоначальной настройки;
-
после замены контроллера или датчика;
-
после изменения порогов и правил;
-
после изменения способов или получателей уведомлений;
-
после изменения сетевой инфраструктуры или системы мониторинга;
-
после изменения автоматических сценариев;
-
периодически в рамках регламентного обслуживания.
Периодическое тестирование позволяет обнаружить неработающий сценарий до того, как он понадобится при настоящей аварии.
Заключение
Система мониторинга должна не только показывать текущее состояние объекта, но и предсказуемо реагировать на нештатные ситуации.
Для этого после настройки необходимо смоделировать основные аварийные события: превышение температуры, срабатывание дискретных датчиков, пропадание электропитания, отказ датчика и предусмотренные автоматические действия.
Особое внимание следует уделять конечному результату: сообщение должно действительно поступить ответственному сотруднику или в систему мониторинга, а автоматическое действие — фактически выполниться.
После устранения причины аварии система должна корректно вернуться в штатное состояние.
Такая проверка позволяет обнаружить ошибки в подключении, настройках порогов, каналах уведомлений и автоматических правилах до возникновения реального инцидента.
Контроллеры NetPing позволяют организовать сбор данных от датчиков, контроль дискретных сигналов, передачу уведомлений и, в зависимости от модели, автоматическое управление исполнительными выходами.
Независимо от используемого контроллера каждый настроенный аварийный сценарий необходимо проверить на практике.
Для подбора оборудования NetPing и консультации по организации мониторинга можно обратиться к специалистам «Алентис Электроникс».
Отдел продаж: sales@alentis.ru
Pre-sale-консультации: pre-sales@alentis.ru
Техническая поддержка: support@netping.ru